
打新总不中签怎么办?散户买新股必看5大量化策略
摩尔线程和沐曦股份这两天彻底激发了打新市场。前者中一签至少赚27万,后者中一签至少赚40万。如果两签都中,够躺平好几年了。牛散葛卫东,更是狂赚上百亿。
不过,量化人,说量化事。今天我们关心两件事。一是如果你有幸中了签,如何决定该在什么价位上卖出?二是如果没有中签,那么是否有上车机会,来共享盛宴?
 阿富汗喀布尔大学,中心图书馆
Step from Amherst, USA, CC BY 2.0
本质上这是一个估值问题。如果我们能知道新股的合理价值,那么就很容易作出决定。
对个股的估值一向很难。但是,对新股则不一定。
新股流通股的持有者主要是机构,机构关于定价,有自己的固有逻辑,因此,股价较为确定。这是股价可以预测的客观因素。只有当一件事有规律可寻,我们才能发现规律。如果股价真的是随机的,不确定的,那么无论用什么样的方法,都是无法预测的。
对于炒作者而言,新股的价格博弈,可以参照的技术指标几乎没有,能参照的数据只有财务指标、中签率等已经固化的数据,特征到收益的关系有可能比较强(即噪声小),因此,我们有可能通过机器学习来找到答案。
这篇文章将帮助你手把手完成一个新股打新模型。
- 如何获得新股数据?
- 如何选择特征
- 模型训练和预测
在这篇文章中,我们还介绍了 Gemini提示词和它的输出能力。
如何获得新股数据?
我们可以通过东方财富网 (https://data.eastmoney.com/xg/) 来获取新股数据。
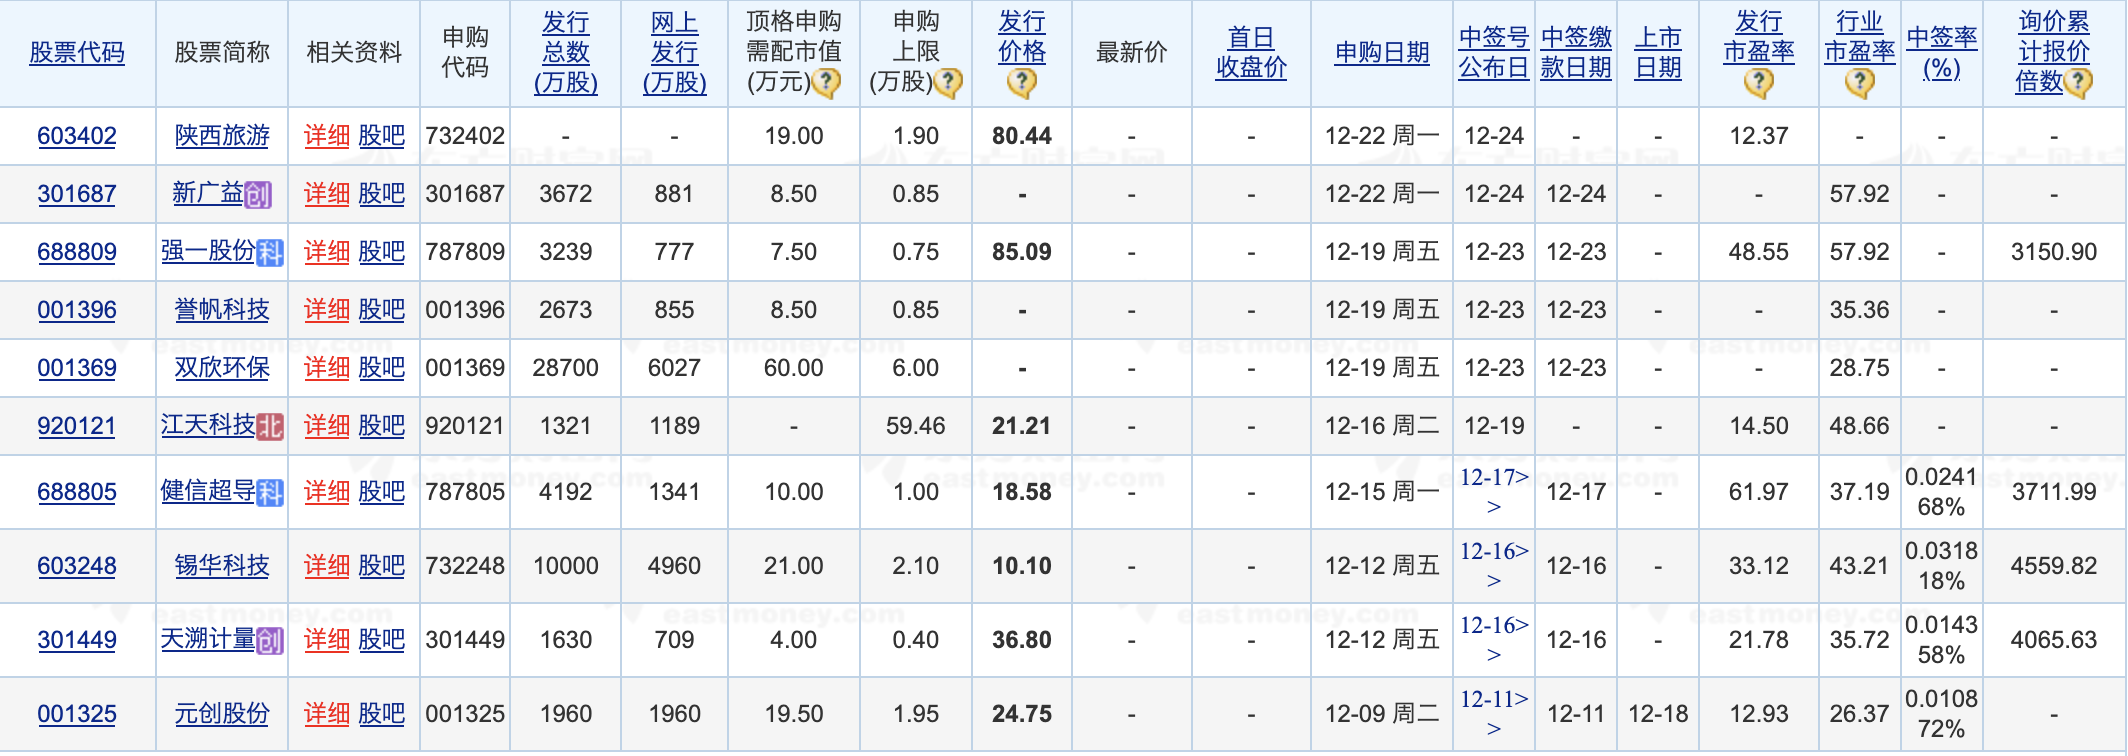
在这些数据中,我们最关心股票代码 , 股票简称 , 发行总数 , 网上发行股数 , 顶格申购需配市值 , 申购上限 , 发行价格 , 行业市盈率 , 询价累计报价倍数 , 配售对象报价家数 , 上市日期,然后,我们要通过 tushare 来获得上市后10日的最高涨幅,作为预测标签。
抓取上述网页的代码如下:
attention
完整可运行代码请在 src-打新不中.ipynb 中查看。可下载到本地运行。运行前修改 data_home 变量即可。# Base params
params = {
"reportName": "RPTA_APP_IPOAPPLY",
"columns": "ALL",
"sortColumns": "APPLY_DATE",
"sortTypes": "-1",
"pageSize": "50",
"filter": "",
"source": "WEB",
"client": "WEB"
}
all_data = []
page_num = 1
while True:
print(f"Fetching page {page_num}...")
params["pageNumber"] = str(page_num)
try:
response = httpx.get(url, params=params)
response.raise_for_status()
data = response.json()
if data.get("success") and data.get("result"):
items = data["result"]["data"]
if not items:
print("No more data found.")
break
all_data.extend(items)
total_pages = data["result"]["pages"]
print(f"Page {page_num} fetched. Total pages: {total_pages}")
# Check exit conditions
if page_num >= total_pages:
break
if max_pages and page_num >= max_pages:
print(f"Reached max pages limit ({max_pages}). Stopping.")
break
# Prepare for next page
page_num += 1
# Random delay between 5 to 10 seconds
delay = random.uniform(5, 10)
print(f"Waiting for {delay:.2f} seconds...")
time.sleep(delay)
else:
print(f"Error or no result on page {page_num}: {data.get('message')}")
break
except Exception as e:
print(f"An error occurred on page {page_num}: {e}")
break
if not all_data:
return None
df = pd.DataFrame(all_data)
return df
如果你不太懂编程,那么可以请 AI 来生成上述代码。
由于它抓取的是 json 版本,所以,返回的字段都是英文。这当然方便编程,但是,我们也要理解数据的含义,以便选择作为训练特征的列。
## 东方财富打新 API 参数速查(rpta_app_ipoapply)
上面这套代码调的是东方财富数据中心接口,把关键参数整理成一张速查表,方便直接复用:
| 参数 | 取值(本例) | 说明 |
| --- | --- | --- |
| 接口地址 | `https://datacenter-web.eastmoney.com/api/data/v1/get` | GET 请求,返回 JSON |
| `reportName` | `RPTA_APP_IPOAPPLY` | 新股申购(IPO 申请)数据集 |
| `columns` | `ALL` | 取全部字段;也可按需列字段名 |
| `sortColumns` / `sortTypes` | `APPLY_DATE` / `-1` | 按申购日期倒序 |
| `pageSize` / `pageNumber` | `50` / 从 1 递增 | 分页拉取,注意循环终止条件 |
| `filter` | 留空(或如 `(APPLY_DATE>='2025-01-01')`) | 服务端过滤,减少传输 |
| `source` / `client` | `WEB` / `WEB` | 固定写法 |
常用关联字段:`上市日期` 对应返回中的 `listing_date`,做"上市后 N 日涨幅"标签时用它对齐行情;估值类查询可用同一接口换 `reportName`(如估值分析相关数据集),参数结构相同。
> 提示:东方财富接口偶尔调整字段名,抓取前先在浏览器开发者工具里确认一次返回结构,再固化到脚本里。
## 应该选择哪些特征?
于是,我再次问 AI:
> ok, 用户关心的字段有 发行总数, 网上发行股数,顶格申购需配市值,申股上限,发行价格,发行市盈率,行业市盈率,询价累计报价倍数,配售对象报价家数,以及股票代码、股票简称,上市日期。<br>
> 这些分别是如何与最终生成的 ipo_data.csv中的字段 对应的?
这次 gemini 给出了映射表:
| 中文名称 | 对应 API 原始字段 | 说明 |
| ---------------- | ------------------------- | ---------------- |
| 股票代码 | SECURITY_CODE | - |
| 股票简称 | SECURITY_NAME | - |
| 发行总数 | TOTAL_ISSUE_NUM | 单位通常为万股 |
| 网上发行股数 | ONLINE_ISSUE_NUM | - |
| 顶格申购需配市值 | TOP_APPLY_MARKETCAP | 单位为万元 |
| 申购上限 | ONLINE_APPLY_UPPER | 网上申购股数上限 |
| 发行价格 | ISSUE_PRICE | - |
| 发行市盈率 | DILUTED_PE_RATIO | 摊薄市盈率 |
| 行业市盈率 | INDUSTRY_PE_NEW | - |
| 询价累计报价倍数 | OFFFLINE_INITIAL_MULTIPLE | 网下初步询价倍数 |
| 配售对象报价家数 | OFFLINE_EP_OBJECT | 网下配售对象家数 |
| 上市日期 | LISTING_DATE | - |
担心自己的思考有盲区,我又问了一句:
> 很好,用户打算做一个机器学习模型来预测新股上市10日内,能达到的最高价。除了用户刚刚提到的这些特征之外,在你爬取的数据中,还有哪些也可以作为特征学习的?为何它们可能对未来10日的收益预测有贡献?
Gemini 的回答特别棒。
## Gemini 的答案
除了您已经提到的字段(如发行价格、市盈率、中签率等),在爬取到的数据中,还有以下几个关键字段非常适合作为机器学习的特征,它们对预测新股上市后的表现(尤其是短期爆发力)有很强的解释逻辑:
**1. MARKET (上市板块)**
这是最关键的特征之一 。不同的板块(创业板、科创板、主板、北交所)有不同的交易规则。
- 例如, 科创板 和 创业板 (以及注册制后的主板)在前5个交易日 不设涨跌幅限制 ,这直接决定了“上市10日内”价格波动的上限空间。
- 旧主板新股首日有44%的涨停限制,随后是10%。
- 逻辑 :板块直接决定了博弈的规则和资金的风险偏好。
**2. ONLINE_ES_MULTIPLE (网上有效申购倍数) / ONLINE_ISSUE_LDR (中签率)**
这是衡量 散户情绪 (Retail Sentiment)的最直接指标。申购倍数越高(或中签率越低),说明市场对该股的热度越高,惜售心理越强,上市初期越容易产生溢价。
**3.INDUSTRY_NAME (所属行业)**
A股市场有极强的 板块轮动 和 赛道炒作 特征。处于热门赛道(如半导体、新能源、AI)的新股,其估值容忍度远高于传统行业(如纺织、银行)。行业本身往往决定了估值的天花板。
**4.UNDERWRITER_ORG (保荐机构/承销商)**
头部券商(“三中一华”等)保荐的项目通常质量经过筛选,且机构定价能力和后续股价维护能力可能更强。承销商的品牌背书效应,以及机构资金的参与程度。
**5. PROFIT (净利润) & NETSUMFINA (净资产)**
这两组数据代表公司的基本面质量 。虽然新股炒作主要看情绪,但基本面太差的公司(尤其是亏损上市)在情绪退潮后跌得更快。这些指标可以作为“安全垫”特征。
**6. PE_DIFF (估值差 - 需衍生)**
这是原始数据的衍生数据。它的计算方式 : 行业市盈率 (INDUSTRY_PE_NEW) - 发行市盈率 (DILUTED_PE_RATIO)。这是打新收益最核心的 安全边际。如果发行市盈率远低于行业平均,说明发行价“便宜”,上市后补涨回归行业均值的动力极强;反之则有破发风险。
真担心 Gemini 来 A 股炒股呀。他还知道三中一华,实在是太可怕了。
## 如何打标签?
根据我们前面介绍的逻辑,我们的策略将是一个回归模型,标签是新股上市10日内,能达到的最高价。我们需要遍历前面得到的数据,对 listing date 小于今天10个交易日的个股,通过 tushare 来获取股份数据,计算10日内的最高收益。
这部分代码比较简单,我们就略过。你可以通过 AI 来生成它们。也可以订阅我们的研究平台会员,或者量化24课,来获得这个策略。
## 构建机器学习模型
构建机器学习模型其实很简单,难一点的是理解模型和进行恰当的调优,这部分在我们的《因子分析与机器学习策略》课程中介绍得很透彻。
对于一个基础版本,我们可以让 AI 来生成代码:
>ok, 现在请构建基于 lightgbm的回归模型。其中股票代码、股票简称、上市日期不作为特征。其它均作为特征。上市板块、所属行业等特征需要预处理为 categorical 的吗?lightgbm 不会进行处理吧?
```python
def train_model():
# 1. 加载数据
df = pd.read_csv(file_path)
# 2. lightgbm 可以接受 features 为 nan,但不允许 target/label 为 nan
# 所以,我们要去掉 target 为nan 的行
df = df.dropna(subset=['上市10日后最高涨幅'])
# 3. 当我们从 csv 中加载数据时,pandas 可能搞错数据类型。我们需要确保数字型列不被
# 当成字符串 -- 这样会被当成 categorical 来处理
numeric_cols_raw = [
'发行总数', '网上发行股数', '总股本', '顶格申购需配市值', '申购上限',
'发行价格', '行业市盈率', '净利润', '净资产',
'网上有效申购倍数', '询价累计报价倍数', '配售对象报价家数'
]
... # 处理方法略
# 4. 偏态处理:对这些列,我们需要进行对数处理,因为它们的分布通常是非常偏斜的
log_candidates = [
'发行总数', '网上发行股数', '总股本', '顶格申购需配市值', '申购上限',
'发行价格', '行业市盈率', '发行市盈率',
'网上有效申购倍数', '询价累计报价倍数', '配售对象报价家数'
]
... # 处理方法略
# 5. 对这些列,我们需要转换为类别变量
... # 处理方法略
# 6. 构建特征矩阵 X 和标签向量 y
X = df[feature_cols]
y = df['上市10日后最高涨幅']
print(f"Training with {len(feature_cols)} features.")
# 7. 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 8. 训练
lgbm = lgb.LGBMRegressor(random_state=42, verbose=-1)
lgbm.fit(X_train, y_train)
# 9. 模型评估
y_pred = best_model.predict(X_test)
mae = mean_absolute_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)
print("-" * 30)
print(f"Test MAE: {mae:.4f}")
print(f"Test R2: {r2:.4f}")
print("-" * 30)
# 10. 感性展示
print("\nTop 5 Test Cases (Actual vs Predicted):")
# Let's take first 5 from the test set
sample_indices = y_test.index[:5]
for idx in sample_indices:
actual = y_test.loc[idx]
# Predict expects a DataFrame
predicted = best_model.predict(X.loc[[idx]])[0]
stock_code = df.loc[idx, '股票代码']
stock_name = df.loc[idx, '股票简称']
print(f"Code: {stock_code}, Name: {stock_name}")
print(f" Actual: {actual:.4f} ({actual*100:.2f}%)")
print(f" Pred : {predicted:.4f} ({predicted*100:.2f}%)")
print(f" Diff : {predicted-actual:.4f}")
print("-" * 20)
# 11. 显示特征的可解释性
print("\nTop 20 Feature Importances:")
importances = pd.DataFrame({
'feature': feature_cols,
'importance': best_model.feature_importances_
}).sort_values('importance', ascending=False)
print(importances.head(20))训练的结果如下:
Test MAE: 0.4096
Test R2: 0.4749
------------------------------
Top 5 Test Cases (Actual vs Predicted):
Code: 2715, Name: 登云股份
Actual: 1.8061 (180.61%)
Pred : 0.6291 (62.91%)
Diff : -1.1770
--------------------
Code: 688036, Name: 传音控股
Actual: 0.9630 (96.30%)
Pred : 1.2864 (128.64%)
Diff : 0.3234
--------------------
Code: 688662, Name: 富信科技
Actual: 1.7514 (175.14%)
Pred : 1.6342 (163.42%)
Diff : -0.1173
--------------------
Code: 603025, Name: 大豪科技
Actual: 2.2560 (225.60%)
Pred : 2.2314 (223.14%)
Diff : -0.0246
--------------------
Code: 600082, Name: 海泰发展
Actual: 1.1409 (114.09%)
Pred : 1.2363 (123.63%)
Diff : 0.0954
--------------------R2只有0.4749,说明这个模型效果并不是很好。它的平均绝对误差(MAE)为0.4096,意味着预测的涨幅与实际涨幅之间的差距平均为40%。因此据此投资,有可能引起较大亏损。
不过,从随机抽取的几个样本来看,准确度却是相当的好。
结果调优
很多人会从纯机器学习的角度来进行调优,包括使用 GridSerchCV 和 RandomizedSearchCV等方法来搜索超参数。但这些方法只是机器学习中的常规方法,它们可能有效,但真正影响模型有效性的原因并不在这里。
比如,新股上市的涨幅严重依赖于近期的行情,因此,我们还应该加上最近一周、一个月、三个月的新股涨幅作为特征,这个特征可以称为市场风格(Market Regime)。
加上这些特征之后,R2有所上升。采样得到的测试数据如下:
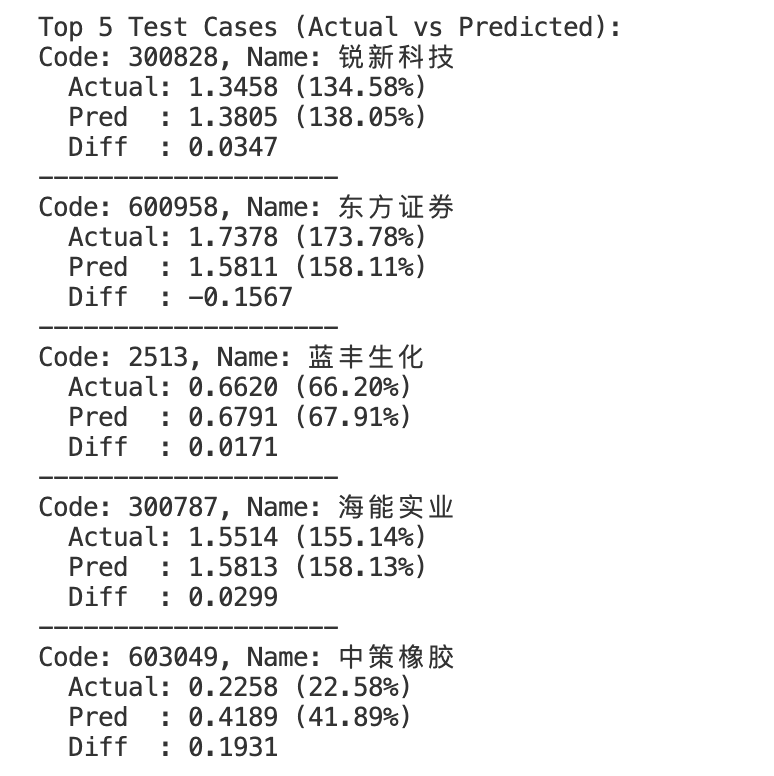
这个数据其实还是很不错的。像锐新科技,实际涨幅达到134.85%,预测误差只有4%左右,算是相当准确了。
另一方面,对模型有效性影响最大的原因可能是数据集的时间跨度太长。在这期间,A 股的打新制度历经多次改革,导致数据中包含了不同的打新规则和机制。因此,模型在训练时使用的历史数据可能与当前实际情况存在较大差异,这么长时间的数据放在一起训练,实际上并没有什么道理,只会导致模型的效果变差。
此外,我们使用了上市后10日的数据来作为标签。如果把时间限制在5日或者3日,那么预测误差也可能更小。不过,此时模型的实际套利能力也可能下降。
不过,这部分工作就留给读者自己研究了。作为严肃的量化领域博主,我们深知,传播方法和思路,远比教一个最终模型更重要。
本文完整源代码可以匡醍研究平台 ,或者《因子分析与机器学习策略》课程中获得。